
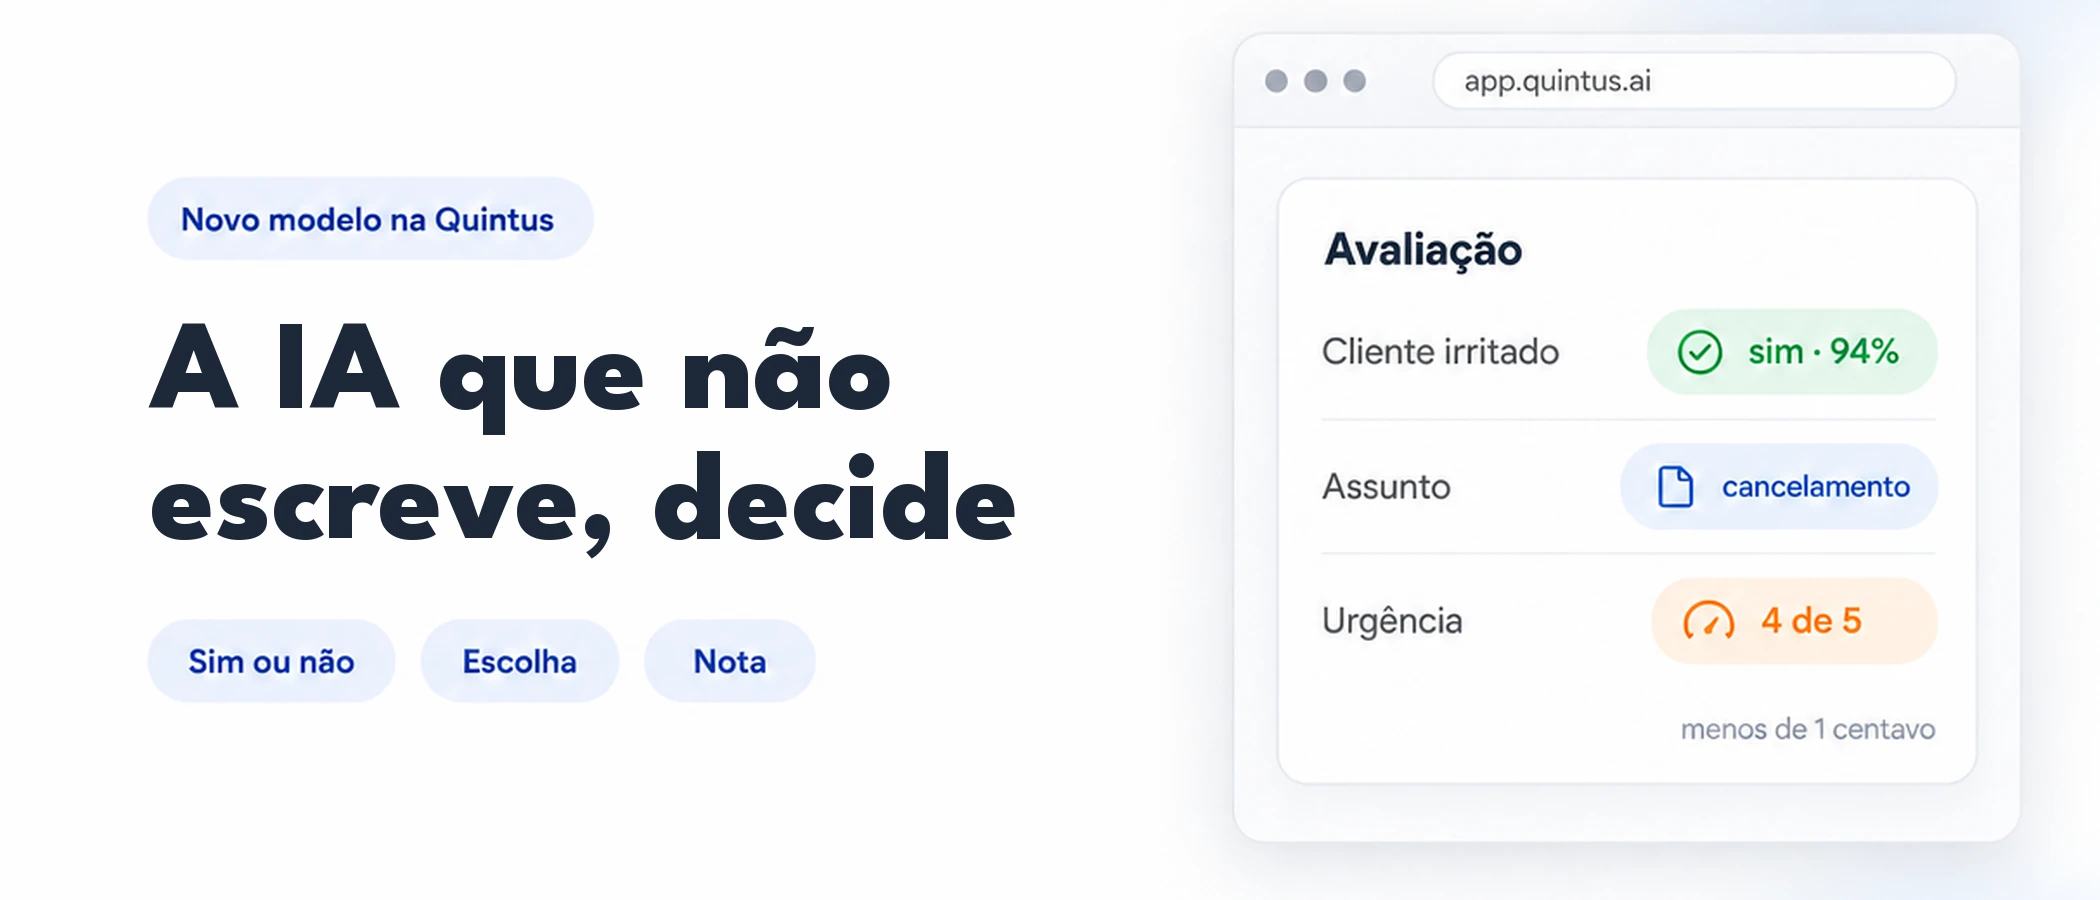
Quase tudo que se fala sobre inteligência artificial gira em torno de modelos que escrevem: respondem perguntas, redigem e-mails, geram código. Só que boa parte do trabalho de uma empresa não é escrever. É decidir: este chamado é urgente? Este cliente está insatisfeito? Este lead vale uma ligação hoje? Esta ação do agente é segura? Acaba de chegar um modelo feito só para esse tipo de pergunta. Ele se chama Jev, não escreve uma linha e responde com um número. Neste artigo explicamos o que ele é, no que ele é diferente, onde ele rende mais e como testar na Quintus.
O que é o Jev
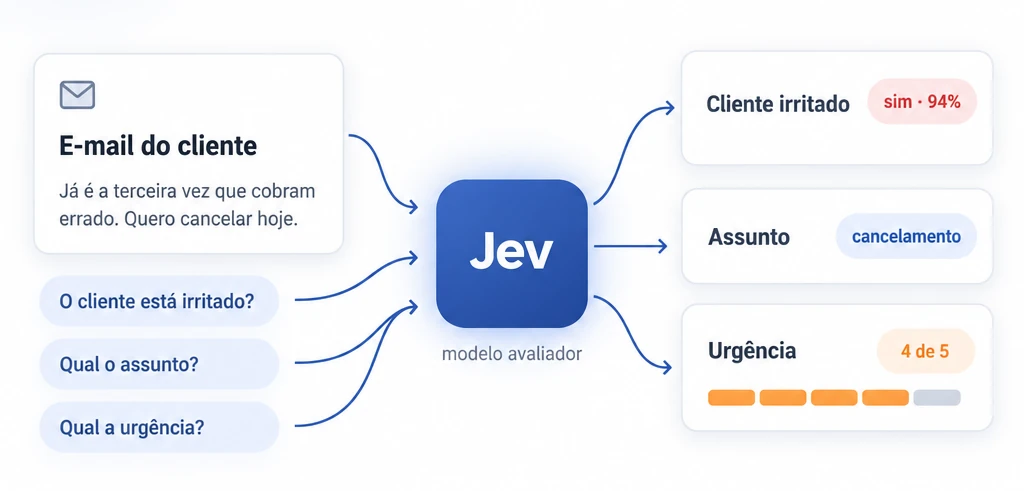
O Jev é um modelo de IA desenvolvido pela TypeSafe AI e distribuído pela Vercel. Ele pertence a uma categoria que começa a ganhar espaço: os modelos avaliadores. Em vez de receber uma conversa e devolver um texto, ele recebe um conteúdo e uma lista de perguntas e devolve uma resposta objetiva para cada pergunta.
Pense num analista muito rápido que lê um e-mail e preenche um formulário: “o cliente está bravo? sim, com 94% de certeza. Qual o assunto? cancelamento. Qual a urgência? 4 de 5.” É exatamente isso que o Jev faz, e nada além disso. Ele não conversa, não resume, não escreve. Por fazer uma coisa só, faz com custo muito baixo e com uma resposta sempre no mesmo formato, pronta para ser usada por um sistema, uma planilha ou um agente.
Os três tipos de pergunta
Sim ou não. “O texto menciona um prazo?”, “O cliente pediu reembolso?”. A resposta vem com o grau de certeza: 97% significa “sim, com bastante segurança”; 52% significa “está em dúvida”. Essa nuance é valiosa, porque permite tratar diferente os casos claros e os duvidosos.
Escolha. “Qual o assunto: financeiro, técnico ou comercial?”. Você define as opções, e o modelo escolhe uma. É a base de qualquer triagem ou roteamento.
Nota. “Qual o nível de interesse do lead: frio, morno, quente ou pronto para comprar?”. Você define a escala, do menor para o maior, e o modelo diz em que ponto dela o conteúdo está. Serve para priorizar, ranquear e medir.
E o detalhe que faz diferença no custo: várias perguntas cabem numa única chamada. Assunto, urgência e sentimento do mesmo chamado saem de uma vez só.
Por dentro: o que entra e o que sai
Vale ver uma avaliação completa, porque ela desfaz a impressão de que isso é complicado. Numa das nossas medições, o conteúdo foi a mensagem de um cliente: “Já é a terceira vez que cobram errado. Quero cancelar hoje.”. As perguntas foram duas: “o cliente está irritado?”, do tipo sim ou não, e “qual a intenção do cliente?”, do tipo escolha, com as opções dúvida, reclamação e cancelamento.
| Pergunta | Tipo | Resposta do Jev |
|---|---|---|
| O cliente está irritado? | Sim ou não | Sim, com 94% de certeza |
| Qual a intenção do cliente? | Escolha | Cancelamento |
A avaliação inteira custou menos de um centésimo de centavo de dólar. Dito de outro jeito: mil avaliações como essa saem por cerca de 1 centavo e meio de dólar. Não veio nenhuma frase, nenhuma explicação e nenhum risco de a resposta chegar fora do formato. Isso facilita a automação: os 94% entram direto numa regra (“acima de 80%, prioridade máxima”), e “cancelamento” manda a mensagem direto para a fila certa. Ninguém precisa ler um texto para agir.
Numa pergunta de nota, a resposta diz em que ponto da sua escala o conteúdo está, inclusive entre dois níveis. Se a escala é “frio, morno, quente, pronto para comprar”, um lead pode sair “entre quente e pronto para comprar, mais perto de pronto”. Isso permite ordenar mil leads do mais para o menos interessado, sem empates.
O que muda (e por que isso é uma virada)
Até aqui, quem queria classificar texto com IA tinha dois caminhos. O primeiro era pedir a um modelo de conversa, como o GPT ou o Claude, que lesse o texto e respondesse. Funciona, mas é como contratar um redator sênior para marcar caixinhas: caro por item, às vezes responde fora do formato pedido e não diz o quanto está seguro. O segundo era treinar um modelo próprio de classificação, o que exige dados rotulados, uma equipe técnica e semanas de trabalho para cada nova pergunta.
O Jev junta o melhor dos dois. Como um modelo de conversa, ele entende perguntas escritas em linguagem natural, sem treinamento. Como um sistema de classificação, devolve respostas curtas, estruturadas e baratas. Uma pergunta nova é só uma linha de texto a mais.
Classificar com um modelo de conversa
Paga por um texto que ninguém vai ler. Às vezes a resposta vem fora do formato e quebra a automação. Sem uma medida de certeza, todo caso parece igual. Em milhares de itens, o custo pesa.
Classificar com o Jev
Paga só pela decisão. A resposta vem sempre no mesmo formato. O grau de certeza separa o caso claro do duvidoso. O custo por item é tão baixo que dá para avaliar tudo, e não só uma amostra.
| Critério | Modelo de conversa | Classificador treinado | Jev |
|---|---|---|---|
| Preparação | Escrever um bom pedido | Rotular milhares de exemplos e treinar | Escrever as perguntas |
| Criar uma pergunta nova | Minutos | Semanas | Minutos |
| Formato da resposta | Texto, às vezes fora do padrão | Fixo | Fixo |
| Grau de certeza | Não informa | Informa | Informa |
| Custo por item | O mais alto dos três | Baixo, depois do investimento inicial | Baixo desde o primeiro item |
| Escreve e raciocina | Sim | Não | Não |
A consequência prática é a mais interessante: análises que não compensavam passam a compensar. Ler todos os chamados do mês, todos os comentários de clientes, todas as respostas de uma pesquisa, cada ação de um agente antes de ela acontecer. Quando avaliar custa quase nada, a pergunta deixa de ser “vale a pena analisar?” e passa a ser “o que mais eu quero saber?”.
O que não muda
O Jev não substitui os modelos de conversa. Ele não escreve a resposta ao cliente, não resume o contrato e não gera código. O desenho que funciona é usar os dois juntos: o Jev decide, rápido e barato, e o modelo de conversa entra só onde é preciso escrever ou raciocinar mais.
Também continua valendo o cuidado com decisões críticas. Uma resposta com 97% de certeza é confiável, mas não é garantia. A boa prática é deixar a automação agir nos casos claros e mandar os duvidosos para uma pessoa. O grau de certeza serve justamente para traçar essa linha.
Dois usos reais, com os pedidos para copiar
Os exemplos abaixo foram feitos na Quintus. Em todos, você só conversa com o assistente. Ele monta um classificador, que é simplesmente uma lista de perguntas salva com um nome, como uma ficha que se preenche para cada texto. Depois, basta chamar a ficha pelo nome, e o Jev a preenche para cada mensagem.
1. Triagem de atendimento
Uma operação de suporte recebe centenas de mensagens por dia, e a primeira tarefa de alguém é ler cada uma e decidir para onde ela vai. Com um classificador, essa triagem acontece na chegada: assunto, urgência e humor do cliente, de uma vez.
- Crie o classificador uma vez
Pedido
Crie um classificador chamado triagem-chamados com três perguntas: o assunto (financeiro, técnico ou comercial), se é urgente (sim ou não) e o humor do cliente numa escala de calmo, incomodado, irritado e furioso.
- Use sempre que quiser
Pedido
Classifique estes chamados com o triagem-chamados e me devolva uma tabela ordenada pelos mais urgentes: [cole os chamados]
No nosso teste, com três chamados reais, o agente acertou os três: “cobrança em duplicidade, preciso resolver hoje” saiu como financeiro e urgente; uma dúvida sobre configuração saiu como técnica e sem urgência; e “o sistema caiu e a loja parou” saiu como técnica e urgente.
2. Priorização de leads
O time comercial recebe formulários, mensagens e respostas de campanha, e nem todo contato está no mesmo momento de compra. Uma pergunta de nota resolve a fila.
Pedido
Crie um classificador chamado qualificacao-leads com: o nível de interesse (frio, morno, quente, pronto para comprar), se a pessoa mencionou orçamento ou prazo (sim ou não) e o porte da empresa (pequena, média ou grande). Depois classifique as mensagens desta planilha e liste primeiro os leads quentes com orçamento.
O mesmo desenho vale para comentários em redes sociais, avaliações de produto e respostas abertas de pesquisas de satisfação: o que antes era lido por amostragem passa a ser lido inteiro.
E na programação?
O Jev também ganhou fama entre equipes de software, e a lógica é a mesma dos exemplos acima. Hoje existem assistentes de IA que programam sozinhos: escrevem código, rodam comandos no computador e propõem mudanças no sistema. Alguém precisa decidir o que eles podem fazer sem pedir permissão. O Jev faz esse papel de fiscal: antes de cada passo, responde se aquilo é seguro, se deu certo ou se merece a atenção de uma pessoa. Ele não escreve o código; ele avalia o que foi feito. Também é usado para decidir qual modelo de IA atende cada pedido: o simples vai para um modelo mais barato, e o complexo, para um mais capaz.
Um caso do começo ao fim
- Defina as perguntas com quem faz a triagem hoje
Quem já encaminha as mensagens sabe quais decisões toma. Neste caso, foram três: a área (financeiro, logística, produto ou outro), se é urgente e se o cliente fala em cancelar ou acionar órgãos de defesa do consumidor.
- Teste com uma amostra que você já conhece
Separe 50 mensagens já encaminhadas e rode o classificador nelas. Compare com o que a equipe decidiu. Onde houver divergência, olhe a pergunta antes de culpar o modelo: quase sempre falta uma opção ou uma palavra está ambígua.
- Escolha onde a decisão segue sozinha
Com a amostra, fica fácil ver a partir de que grau de certeza o modelo não erra. Um ponto de partida comum: acima de 80% ou abaixo de 20%, a decisão segue automática; entre os dois, vai para uma pessoa.
- Coloque para rodar sozinho
Uma tarefa agendada classifica as mensagens novas a cada hora, encaminha as claras e reúne as duvidosas numa lista curta para revisão.
O resultado muda a conta da operação. As 12.000 avaliações custam, pela medição do nosso teste, cerca de 16 centavos de dólar por mês, menos de R$ 1. A pessoa que fazia a triagem passa a revisar só os casos duvidosos e a resolver os urgentes, que agora chegam primeiro. E, como toda mensagem passa pelo mesmo critério, a empresa ganha um dado que não tinha: quantas mensagens por área, quantas urgentes e quantas com risco de cancelamento, mês a mês.
Três formas de combinar o Jev com outros modelos
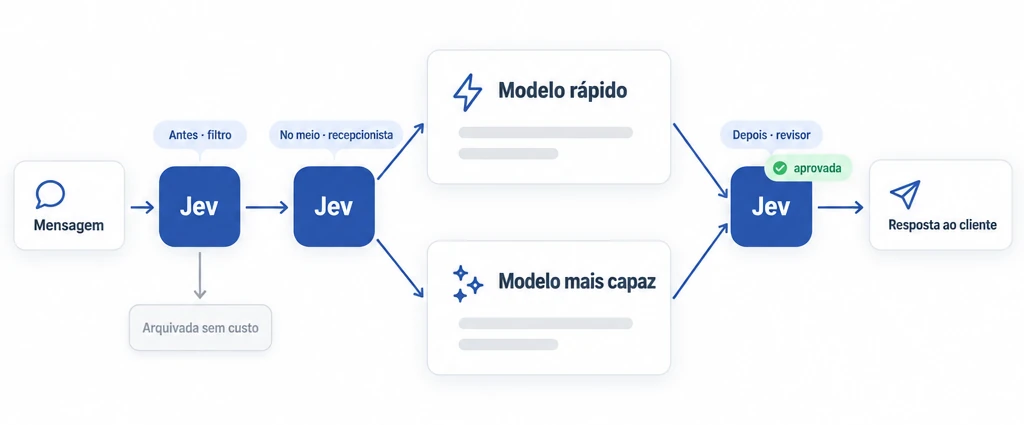
O Jev rende mais quando trabalha junto com os modelos de conversa. Na prática, ele aparece em três posições.
Antes: o filtro. O Jev lê tudo e só manda para o modelo mais caro o que precisa de uma resposta escrita. Das 12.000 mensagens do caso acima, talvez só as reclamações precisem de um rascunho de resposta. O modelo de conversa trabalha menos, e a conta cai.
No meio: o recepcionista. O Jev decide para onde cada pedido vai: qual equipe, qual agente ou qual modelo. Um pedido simples vai para um modelo rápido; um complexo, para o mais capaz. É o mesmo raciocínio de um bom atendimento de recepção, aplicado à IA.
Depois: o revisor. Antes de uma resposta sair, o Jev confere: “a resposta atende ao que o cliente pediu?”, “contém alguma promessa de prazo ou valor?”, “o tom está adequado?”. O que não passa volta para ajuste ou vai para uma pessoa. É a posição que traz mais segurança para quem coloca agentes falando com clientes.
Como escrever perguntas que acertam
A qualidade da resposta depende quase toda da pergunta. Como o Jev não conversa, ele não tem como pedir esclarecimento: responde exatamente o que foi perguntado. Quatro cuidados resolvem a maior parte dos problemas.
- Uma ideia por pergunta
“O cliente está irritado e quer cancelar?” são duas perguntas. Separe em “o cliente está irritado?” e “o cliente pediu cancelamento?”. Assim você sabe qual das duas foi respondida.
- Opções que não se sobrepõem
Numa escolha, cada texto deve caber em uma opção só. “Financeiro, cobrança e pagamento” confunde; “financeiro, técnico e comercial” separa bem. Se houver casos que não cabem em nenhuma, crie a opção “outro”.
- Escalas em ordem e com nomes claros
Numa nota, liste os níveis do menor para o maior e dê a cada um um nome que qualquer pessoa entenderia: “frio, morno, quente, pronto para comprar”. Evite escalas longas: quatro ou cinco níveis bastam.
- Teste com dez casos reais antes de usar em volume
Rode o classificador em dez textos que você já sabe classificar. Se errar algum, quase sempre é a pergunta que está ambígua. Ajuste e rode de novo.
20 pedidos prontos para copiar
Troque o que está entre colchetes pelos seus dados. Todos funcionam numa conversa da Quintus.
Atendimento
- Crie um classificador chamado triagem-chamados que diga o assunto (financeiro, técnico, comercial ou outro) e se o chamado é urgente.
- Classifique estes chamados com o triagem-chamados e agrupe por assunto: [chamados]
- Destes atendimentos, quais clientes demonstram risco de cancelar? Use uma escala de nenhum, baixo, médio e alto: [conversas]
- Avalie se cada resposta do nosso time resolveu o problema do cliente (sim ou não) e se o tom foi cordial: [respostas]
Vendas
- Crie um classificador chamado qualificacao-leads com o nível de interesse (frio, morno, quente, pronto para comprar) e se a pessoa mencionou orçamento.
- Classifique estas mensagens de leads e liste primeiro os quentes: [mensagens]
- Destas propostas perdidas, qual foi o motivo principal: preço, prazo, concorrente ou falta de resposta? [anotações]
- Estes e-mails de clientes pedem algo além do que já compraram? Responda sim ou não e diga o produto: [e-mails]
Marketing
- Classifique estes comentários por sentimento (negativo, neutro ou positivo) e por tema (preço, qualidade, entrega ou atendimento): [comentários]
- Destas avaliações do produto, quais mencionam um defeito? [avaliações]
- Dê uma nota de clareza (confuso, razoável, claro, muito claro) para cada um destes títulos de anúncio: [títulos]
- Estas respostas abertas da pesquisa de satisfação sugerem uma melhoria concreta? [respostas]
Operações e financeiro
- Classifique estas notas de despesa por categoria (viagem, alimentação, software, material ou outro): [descrições]
- Destes e-mails de fornecedores, quais comunicam atraso na entrega? [e-mails]
- Estes pedidos de compra têm todas as informações necessárias (produto, quantidade, prazo e centro de custo)? [pedidos]
- Dê uma nota de gravidade (baixa, média, alta, crítica) para cada ocorrência deste relatório: [ocorrências]
Jurídico e compliance
- Estas cláusulas preveem multa por rescisão? Responda sim ou não para cada uma: [cláusulas]
- Destes contratos, qual o tipo: prestação de serviço, fornecimento, confidencialidade ou outro? [trechos]
- Este texto contém dados pessoais, como CPF, telefone ou endereço? [texto]
- Esta mensagem para clientes promete algo que a empresa não pode garantir? [mensagem]
Os erros que mais atrapalham
Pedir texto a um modelo que não escreve. Se a tarefa é resumir, explicar ou redigir, o Jev não é a ferramenta. Use um modelo de conversa e deixe o Jev para a decisão.
Tratar o grau de certeza como garantia. Uma resposta com 55% de certeza é quase um cara ou coroa. Defina a partir de que valor a decisão segue sozinha e mande o resto para uma pessoa.
Mudar as perguntas sem avisar ninguém. Se o time compara os números de um mês com os do anterior, a pergunta precisa ser a mesma. Guardar o classificador com um nome ajuda: todos usam a mesma versão.
Mandar o documento inteiro quando a decisão está num trecho. Quanto mais focado o conteúdo, mais precisa a resposta. Para um contrato longo, avalie as cláusulas separadamente.
Como saber se continua funcionando
Um classificador que acertou no primeiro mês pode errar no sexto, e quase nunca por culpa do modelo: é o conteúdo que muda. Surge um produto novo, uma campanha traz outro tipo de cliente, um problema novo vira assunto frequente. Por isso vale criar o hábito de uma conferência mensal curta: sorteie 20 itens já classificados, peça para alguém da equipe dizer se concorda e anote a taxa de acerto.
Dois sinais pedem ajuste. O primeiro é a opção “outro” crescendo, porque apareceu um tipo de caso que as perguntas não previam. O segundo é o aumento de respostas na faixa de dúvida, entre 40% e 60% de certeza, porque a pergunta ficou ambígua para o conteúdo atual. Nos dois casos, a solução é revisar as perguntas, não trocar de ferramenta.
Como isso funciona na Quintus
Na Quintus, o Jev chega de três formas. A primeira é o classificador na conversa: qualquer agente pode criar classificadores com um nome, guardar para a empresa e reutilizar quantas vezes quiser, inclusive em tarefas agendadas. A segunda é o modelo direto, para quem quer montar um agente dedicado a uma única classificação e chamá-lo de outros fluxos. A terceira é a verificação de segurança das ações dos agentes, que pode ser ativada por empresa.
O uso é cobrado como o de qualquer outro modelo da plataforma, pelo que foi consumido. Como cada avaliação custa uma fração de centavo, fica viável analisar volumes que antes não cabiam no orçamento.
Sempre de olho no que chega
O mercado de IA lança novidades toda semana, e a maioria não muda nada no dia a dia de uma empresa. O Jev é diferente porque ataca um custo concreto: o de decidir em escala. Por isso ele entrou na plataforma pouco depois do lançamento.
É assim que trabalhamos: acompanhamos de perto o que surge, testamos com casos reais e trazemos para os clientes o que de fato melhora o resultado, já integrado, com governança e sem que ninguém precise contratar um fornecedor novo. O Jev também vai entrar em outros processos da própria plataforma, como a checagem da qualidade das respostas antes da entrega e a escolha do melhor caminho para cada pedido, com ganho de desempenho e de qualidade para quem usa.
Perguntas frequentes
O Jev substitui o ChatGPT, o Claude ou o Gemini?
Não. Ele não escreve textos. Ele complementa esses modelos: decide rápido e barato, e deixa para eles o que exige escrever ou raciocinar.
Preciso treinar o modelo com os meus dados?
Não. Você escreve as perguntas em linguagem natural e ele responde. Para mudar o que é avaliado, basta mudar as perguntas.
Ele funciona em português?
Sim. Os exemplos deste artigo foram feitos com textos e perguntas em português.
O que significa a porcentagem na resposta?
É o grau de certeza do modelo. Perto de 100% é um “sim” firme; perto de 0%, um “não” firme; perto de 50%, dúvida. Use essa faixa para decidir o que segue automático e o que vai para revisão de uma pessoa.
Dá para usar em tarefas automáticas?
Sim. Um classificador salvo pode ser usado por um agente numa tarefa agendada, por exemplo para triar todo dia os chamados novos e enviar só os urgentes.
Os classificadores ficam visíveis para toda a empresa?
Ficam guardados no ambiente da sua empresa, com um nome, para que todos usem a mesma versão das perguntas.
Quanto custa?
O uso é cobrado como o de qualquer modelo da plataforma. Numa avaliação curta, com duas perguntas, o custo medido no nosso teste foi de cerca de 1 centavo e meio de dólar a cada mil avaliações.
Conclusão: nem toda IA precisa escrever
Muito do valor da IA nas empresas vai vir de decisões pequenas, repetidas milhares de vezes: separar, priorizar, sinalizar, bloquear. O Jev torna essas decisões baratas o bastante para aplicar em tudo, com respostas objetivas e o grau de certeza de cada uma. O melhor jeito de entender é testar com uma pergunta real do seu negócio.

Deixe um comentário